スピーチ・トゥ・スピーチ
Voice AI エージェント は、早期アクセス機能として利用できます。アクセスまたは詳細を確認するには、専任のアカウントマネージャーまたは サポートにお問い合わせください。
音声読み上げ を選択した場合は、次のフィールドを構成します。
Voice処理
エージェントが応答に使用するモデルと音声を設定し、発話速度とノイズリダクションを調整します。
- モデル: 応答のモデルを選択します。フルバージョンとミニバージョンの両方のリアルタイムモデルから選択できます。
- Voice: これは必須フィールドです。モデルが応答に使用する音声を選択します。
- 速度:発話速度を設定します。デフォルト値は 1.00 です。
- ノイズリダクション:これは必須フィールドです。ノイズリダクションのタイプを選択します。近距離のマイク(電話やヘッドフォンなど)には近距離フィールドを使用し、遠距離で使用されるマイク(モバイルスピーカーフォンや会議室のセットアップなど)には遠距離フィールドを使用します。
ターン検出
話者が話し終えたことをエージェントが検出する方法を選択します。サーバー音声アクティビティ検出 または セマンティック音声アクティビティ検出 を選択し、選択したフィールドを構成します。
サーバー音声アクティビティの検出
サーバー側の音声アクティビティ検出を使用して、ユーザーが話し終えたタイミングを検出します。このモデルは、音声レベルを監視し、無音時間を測定し、ユーザーが話し終えた確率に基づいて応答タイムアウトを調整します。これは、無音の解釈方法を予測可能で構成可能な制御が必要な場合に使用します。
次のフィールドを設定します。
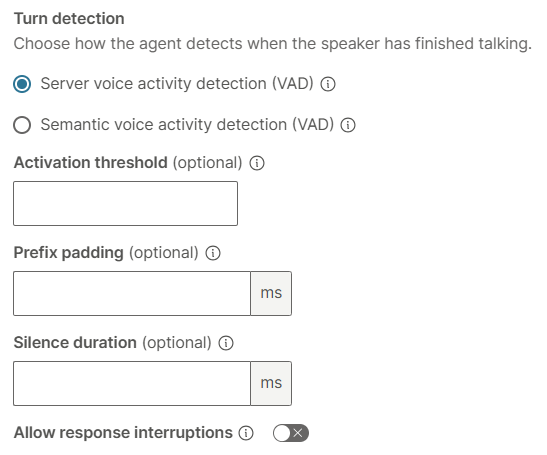
- アクティブ化しきい値 (省略可能): 音声アクティビティ検出の感度を 0.0 から 1.0 のスケールで設定します。値を大きくすると、音声として登録するためにより大きな音声が必要になるため、ノイズの多い環境での誤ったトリガーが減少します。値を小さくすると感度が上がり、静かな設定や物腰の柔らかいユーザーに適しています。
- プレフィックス パディング (オプション): プレフィックス パディングは音声クリッピングを解決します。VAD は音声が開始されたことを検出するのに時間がかかるため、検出がトリガーされる前に最初のミリ秒の音声が失われます。プレフィックス パディングは、オーディオ バッファーをわずかに巻き戻して、その事前検出オーディオを再キャプチャするため、モデルは実際の開始から完全な発話を受け取ります。値はミリ秒単位です。
- 無音の持続時間 (オプション): 音声が終了したと見なされるまでに、何ミリ秒の連続無音が発生する必要があるかを設定します。値を小さくすると、エージェントの応答は速くなりますが、文の途中での自然な一時停止が中断されるリスクが高くなります。ノイズの多い環境や、ユーザーが思考を完了するのにさらに時間が必要な場合は、700 から 1000 ミリ秒を使用します。より高速で応答性の高いエクスペリエンスを実現するには、200 から 400 ミリ秒を使用します。
- 応答中断を許可: 有効にすると、ユーザーが再び話し始めると、AI は現在の応答を停止します。
セマンティック音声アクティビティの検出
セマンティック分析を使用して、ユーザーがいつ話し終えたかを検出します。このモデルは、ユーザーの言葉が完全な思考を形成しているかどうかを評価し、その確率に基づいて応答タイムアウトを調整します。このアプローチは、バックグラウンドノイズに対してより耐性があり、文の途中で自然な一時停止中にユーザーを遮断する可能性が低くなります。
次のフィールドを設定します。
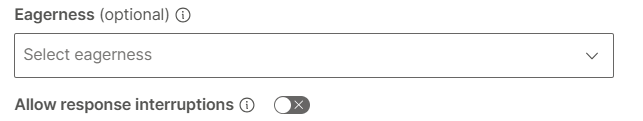
- 熱意 (オプション): ユーザーが話し終えた後のエージェントの応答速度を制御します。高 は、スピーチの終わりが発生したとすぐに応答します。低 は、ユーザーが終了したことを確認するまでより長く待つため、エージェントが思考の途中で中断する可能性が低くなります。中がデフォルトです。
- 応答中断を許可: 有効にすると、ユーザーが再び話し始めると、AI は現在の応答を停止します。
入力文字起こし
文字起こしモデルや言語など、発信者の音声の文字起こし方法を設定します。
次のフィールドを設定します。
-
プロンプト (省略可能): テキスト文字列を入力して、文字起こしモデルを会話で予想される語彙、スペル、言い回しに偏らせます。このフィールドは、認識エンジンへのヒントとしてのみ機能します。これは、オーディオがテキストにデコードされる方法には影響しますが、モデルの会話動作は変更されません。固有名詞、頭字語、ドメイン固有の言語など、モデルが聞き間違えたり、一貫性のない文字起こしをしたりする可能性のある用語に使用します。
-
モデル (オプション): エンド ユーザーの音声の文字起こしに使用するモデルを選択します。
モデル 説明 ユースケース GPT 4.0 文字起こし GPT-4o アーキテクチャ上に構築されています。特にアクセントのある音声、重複する音声、複雑な語彙に対して、単語エラー率を低く抑えます。 正確さが優先される場合に、単語エラー率を最も低くするために使用します。たとえば、アクセントのあるスピーチ、技術的な語彙、または低音質を処理する場合などです。 GPT 4.0 ミニ文字起こし GPT 4.0 Transcribe の軽量で高速なバリアント。GPT 4.0 Transcribeよりもレイテンシーが短縮され、コストが低くなります。精度はフルモデルよりも低くなります。 大量導入において、速度とコストの最適なバランスを提供します。ターンあたりの待機時間が会話の質に直接影響する場合に使用します。 メモ最高のエクスペリエンスを得るには、GPT 4.0 Mini Transcribe を使用してください。 -
ユーザー言語 (オプション): 入力オーディオの言語。
非アクティブ処理
これらの設定を使用して、発信者が応答を停止したときのエージェントの動作を制御します。しばらく沈黙した後、エージェントは会話を進めるために再エンゲージメント プロンプトを送信します。設定された再試行回数後に発信者が沈黙を保つと、エージェントは通話を終了するか、ジャーニーに制御を戻します。
次のフィールドを設定します。
- タイムアウト: エージェントが再エンゲージメント プロンプトを送信する前に許可する発信者の沈黙の数ミリ秒を設定します。これを通常のラウンドトリップ待機時間に対して調整して、発信者が応答を待機している間にプロンプトが発生しないようにします。
- タイムアウト後の再試行: エージェントが通話を終了するか、ジャーニーに戻る前に、エージェントがサイレント発信者と再エンゲージする回数を選択します。
すべてのフィールドを設定したら、チェックマークを選択して入力を検証します。
関連情報
 インバウンド Voice AI エージェントを設定する
 アウトバウンド Voice AI エージェントを設定する
AIエージェントへの通話転送:はじめに
IVR (自動音声応答) フローからのアクティブな通話をリアルタイム Voice AI エージェントに引き継ぎます。
音声テキスト読み上げ
音声テキスト読み上げエージェントの音声設定、文字起こし、非アクティブ処理、および無音設定を構成します。
通話セッションの結果を管理する
呼び出しセッションの終了後に何が起こるかを、エレメント ブランチを使用して処理します。
Voice AI エージェントの起動準備
音声プロンプトを作成し、セットアップを確認し、ライブ配信前にテストします。